
近日,中国科学院合肥物质院健康所/合肥肿瘤医院表观组学与智能解析团队张帆研究员、谷红仓研究员指导研发出一种融合小分子多模态信息与蛋白质全长序列—结构特征的药物—靶点亲和力预测模型——HelixDTA。该模型能够同时刻画药物分子的化学语义与拓扑结构,并充分利用蛋白质全长序列及三维结构信息,在常规测试、冷启动预测及模型可解释性等方面表现出良好的预测能力。相关研究成果以“HelixDTA: Full-length Sequence-Structure Learning for Robust and Interpretable Drug-Target Affinity Prediction”为题发表于《Journal of Chemical Information and Modeling》。论文共同第一作者为健康所博士研究生娄上和李徐华、硕士研究生彭宇杰。
药物—靶点亲和力(Drug-Target Affinity,DTA)预测是人工智能辅助药物发现中的重要基础任务,其目标是利用计算方法预测小分子药物与蛋白质靶点之间的结合强度,从而帮助研究人员从海量候选化合物中快速筛选潜在活性分子,降低实验筛选成本并提高药物研发效率。然而,药物—靶点相互作用受到分子化学结构、蛋白质序列以及三维空间构象等多种因素共同影响。现有方法往往侧重于单一模态信息,或仅利用蛋白质局部结构,难以充分表征复杂的分子相互作用关系。同时,在面对训练过程中未出现的新型化合物骨架和远缘蛋白靶点时,模型的泛化能力仍面临较大挑战。
针对上述问题,研究团队构建了HelixDTA深度学习框架。在药物端,模型同时输入SMILES序列和分子图结构,分别学习分子的化学语义信息与原子拓扑关系;在蛋白质端,则将氨基酸序列与全长残基级三维结构图进行联合建模,使模型能够同时感知蛋白质的序列特征和空间邻接关系。在此基础上,HelixDTA进一步利用门控注意力机制对不同模态特征进行自适应融合,从而获得更加完整的药物和靶点表征,并用于药物—靶点亲和力预测。
实验结果表明,HelixDTA在Davis、KIBA等经典药物—靶点亲和力数据集上取得了稳定的预测性能。为进一步评估模型在真实药物发现场景中的泛化能力,研究团队分别设计了drug-scaffold、protein-sequence和protein-structure三类冷启动任务,用于模拟未知化学骨架、远缘蛋白序列以及新型蛋白质结构等情况。结果显示,融合全长蛋白质结构信息和多模态药物特征后,模型在多个冷启动场景下均展现出较好的鲁棒性。
此外,研究团队进一步对模型的内部表征和注意力机制进行了分析。结果发现,HelixDTA能够自动关注与药物结合和蛋白功能相关的重要区域,说明模型不仅能够完成亲和力数值预测,还能够学习到具有一定生物物理意义的结构特征,从而提升模型的可解释性。
该研究表明,将药物多模态信息与蛋白质全长序列—结构信息进行统一建模,是提升药物—靶点亲和力预测泛化能力和可解释性的一种有效策略。HelixDTA为未知化合物和未知靶点的虚拟筛选提供了新的计算工具,也为人工智能驱动的先导化合物发现及药物研发提供了新的技术基础。
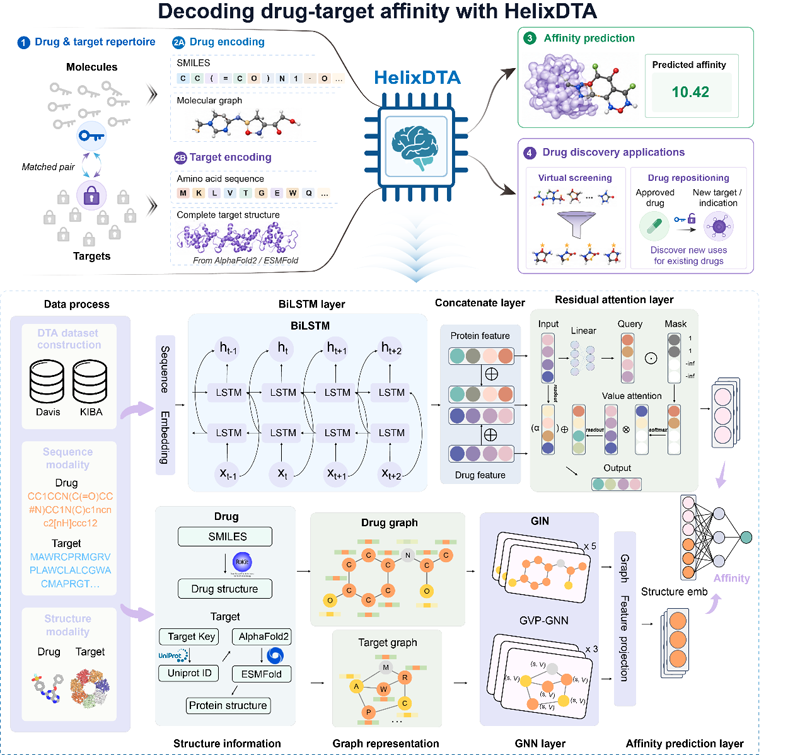
图1:HelixDTA模型框架
该研究工作得到了安徽省科技重大专项、安徽省杰青项目(2408085J017)、卫健委四大慢病重大专项“结直肠癌及癌前病变的风险识别、筛查早诊及干预研究”(2024ZD0520100)等项目的资助与支持。
文章链接:https://doi.org/10.1021/acs.jcim.6c01759
 地址:合肥市蜀山区仰桥路68号(皖山路与仰桥路交口西北角) 邮编:230000 电话:0551-65595111 邮箱:hospital@hfcas.ac.cn